AIが数字を読むしくみ
お好み焼きの数字を、AIはどうやって読んだのでしょう? あなたが撮った写真の本物のデータで、順番に見ていきましょう。
- MNIST
- 画像は数字
- 前処理
- CNN
- 学習
※ まだ撮影していないので、見本のデータで表示しています。撮影すると、あなたのお好み焼きのデータに変わります。
STEP 1
MNIST ― AIの「最初の練習問題」
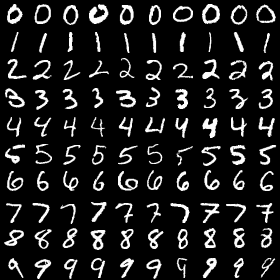
MNIST(エムニスト)は、たくさんの人が書いた手書きの数字 0〜9 を集めた画像データです。画像認識AIを作るとき、世界中の研究者や学生が最初に試す定番の練習問題です。
- 枚数
- 70,000枚(学習用 6万+テスト用 1万)
- 大きさ
- 28×28ピクセル
- 色
- 黒地に白グレースケール
- 正解
- 0〜9の 10 種類
MNIST の画像は黒い背景に白い数字です。ソースを塗ったお好み焼きに白いマヨネーズで数字を描くと、見た目がこれに近くなります。この企画は、この点に注目して作りました。
STEP 2
AIにとって、画像は「数字の表」
人間には「数字の絵」に見えても、コンピュータが受け取るのは 28×28 = 784 個の数字です。0 が真っ黒、9 が真っ白。下の図をタップして切り替えてみましょう。
スマホで撮った写真やゲームの画面も、コンピュータの中では同じように数字の並びとして扱われています。
STEP 3
前処理 ― AIに見せる前のひと工夫
写真をそのままAIに見せても、うまく読めません。マヨネーズの線だけを取り出し、MNIST と同じ形にそろえる前処理が必要です。同じ写真を 2 つの方法で処理すると…
写真マヨらしさ取り出した線AIへの入力答え
v1
?
v2
?
数字として使った部分ノイズとして除いた部分
v2 の 5 つの工夫(v1 からの改良点)
- 周りより明るい線を探すv1 は「白い部分」を探していました。本物のマヨは黄色っぽく、下の白いナプキンのほうが「白い」と判定されてしまいます。v2 は「周りより明るい細い線」を探す方法(トップハット変換)に変え、広く明るい面を無視できるようにしました。
- 色で見分ける緑と赤の比(G/R)を使い、オレンジ色の焼けた生地のふちや、ピンク色のかつお節を弱めます。
- しきい値を賢く決めるv1 は決まった値で「白いかどうか」を判断していました。v2 は写真ごとに、お好み焼きの中心部の明るさから自動で決めます(大津の方法)。マヨが無いときは無理に探しません。
- 見る範囲をしぼり、ノイズを除くv1 は写真全体を見ていました。v2 はガイド円の中だけを見て、皿の縁・数字を囲む生地のふち・小さなテカリを取り除きます(連結成分の解析)。
- MNIST に寄せるマヨの線の太さを、MNIST の手書き文字と同じくらいにそろえます(膨張・収縮)。AIが学習したデータに近い形で見せるほど、正しく読めます。
AI(CNN)は v1 と v2 で同じで、違うのは前処理だけです。練習用に作ったお好み焼きの合成写真 500 枚では、正解率が v1 の 22% から v2 では 96% になりました。
STEP 4
CNN ― 小さなフィルタで特徴を見つける
このAIは畳み込みニューラルネットワーク(CNN)です。3×3 の小さなフィルタを画像の上で少しずつずらしながら掛け算して、「縦線」「横線」「曲がり角」などの特徴を探します。
入力28×28
畳み込み116枚 28×28
畳み込み232枚 14×14
畳み込み364枚 7×7
全結合128
出力0〜9
学習で身につけた 16 個のフィルタ(畳み込み1)
プラスの重みマイナスの重み
あなたの数字に、フィルタを掛けた結果(特徴マップ)
層が深くなるほど、特徴はより抽象的になります(畳み込み3では 7×7 が 64 枚)。最後に全結合層が「0〜9 のどれらしいか」を確率で答えます。
畳み込み3の特徴マップ(64 枚)
STEP 5
学習 ― 6 万枚の手書き数字から
- 学習した画像
- 12万枚(MNIST 6万+線の太さをそろえた 6万)
- くり返し
- 10周
- パラメータ
- 約 9.8万個の重み
- テスト正解率
- 99.6%(1万枚)
AIは最初、でたらめな重みから始まります。答えを間違えるたびに、正解に近づくよう重みを少しずつ直す(誤差逆伝播法)ことをくり返して、数字の読み方を身につけました。
学習したAIは、このスマホの中で動いています。写真をインターネットに送らずに、スマホだけで計算しています。
もっと知りたい人へ
JINNO LAB
神野研究室
東京都市大学
情報工学部
知能情報工学科